Connectez la production, configurez les règles une seule fois et livrez des données réalistes et réversibles dans chaque environnement qui en a besoin : développement, test, analytics et IA.
Chaque écran ci-dessous est issu de la console Pseudia réelle : découvrez comment une équipe configure et exécute la pseudonymisation au quotidien.
Créez un espace de travail par équipe ou département (BI, analytics, ingénierie) et laissez chacun configurer ses propres sources et environnements de données.
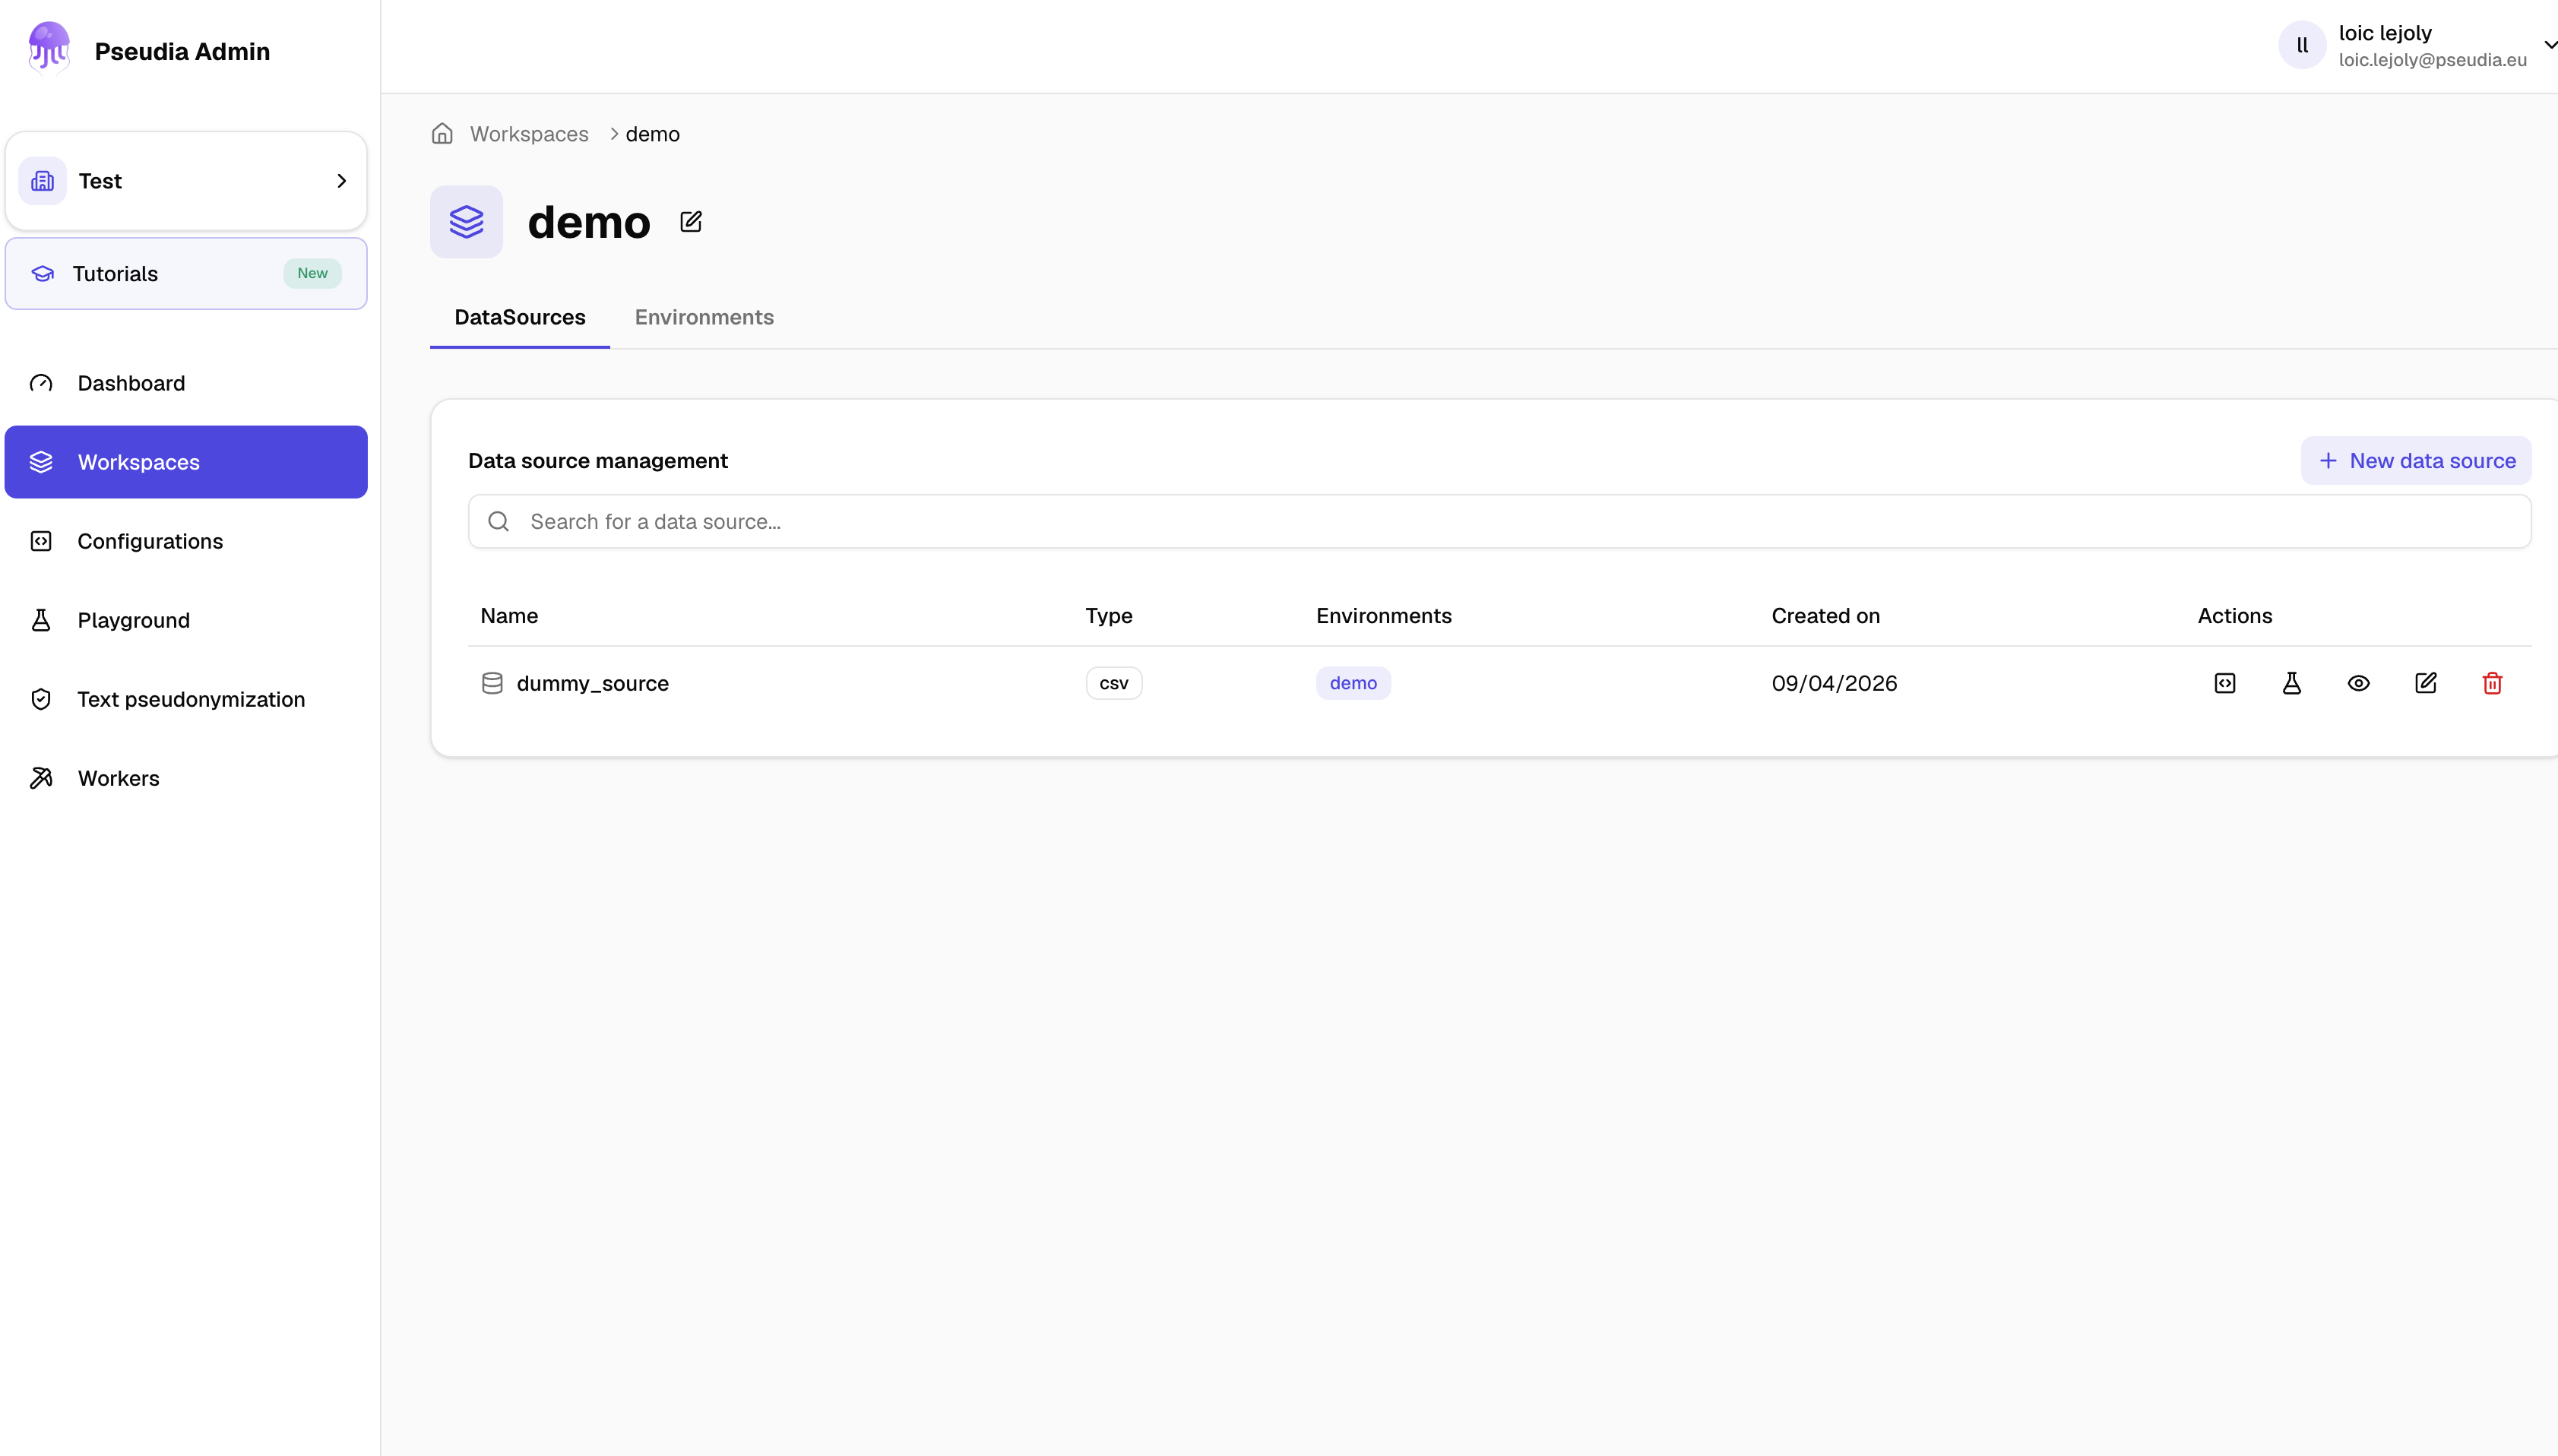
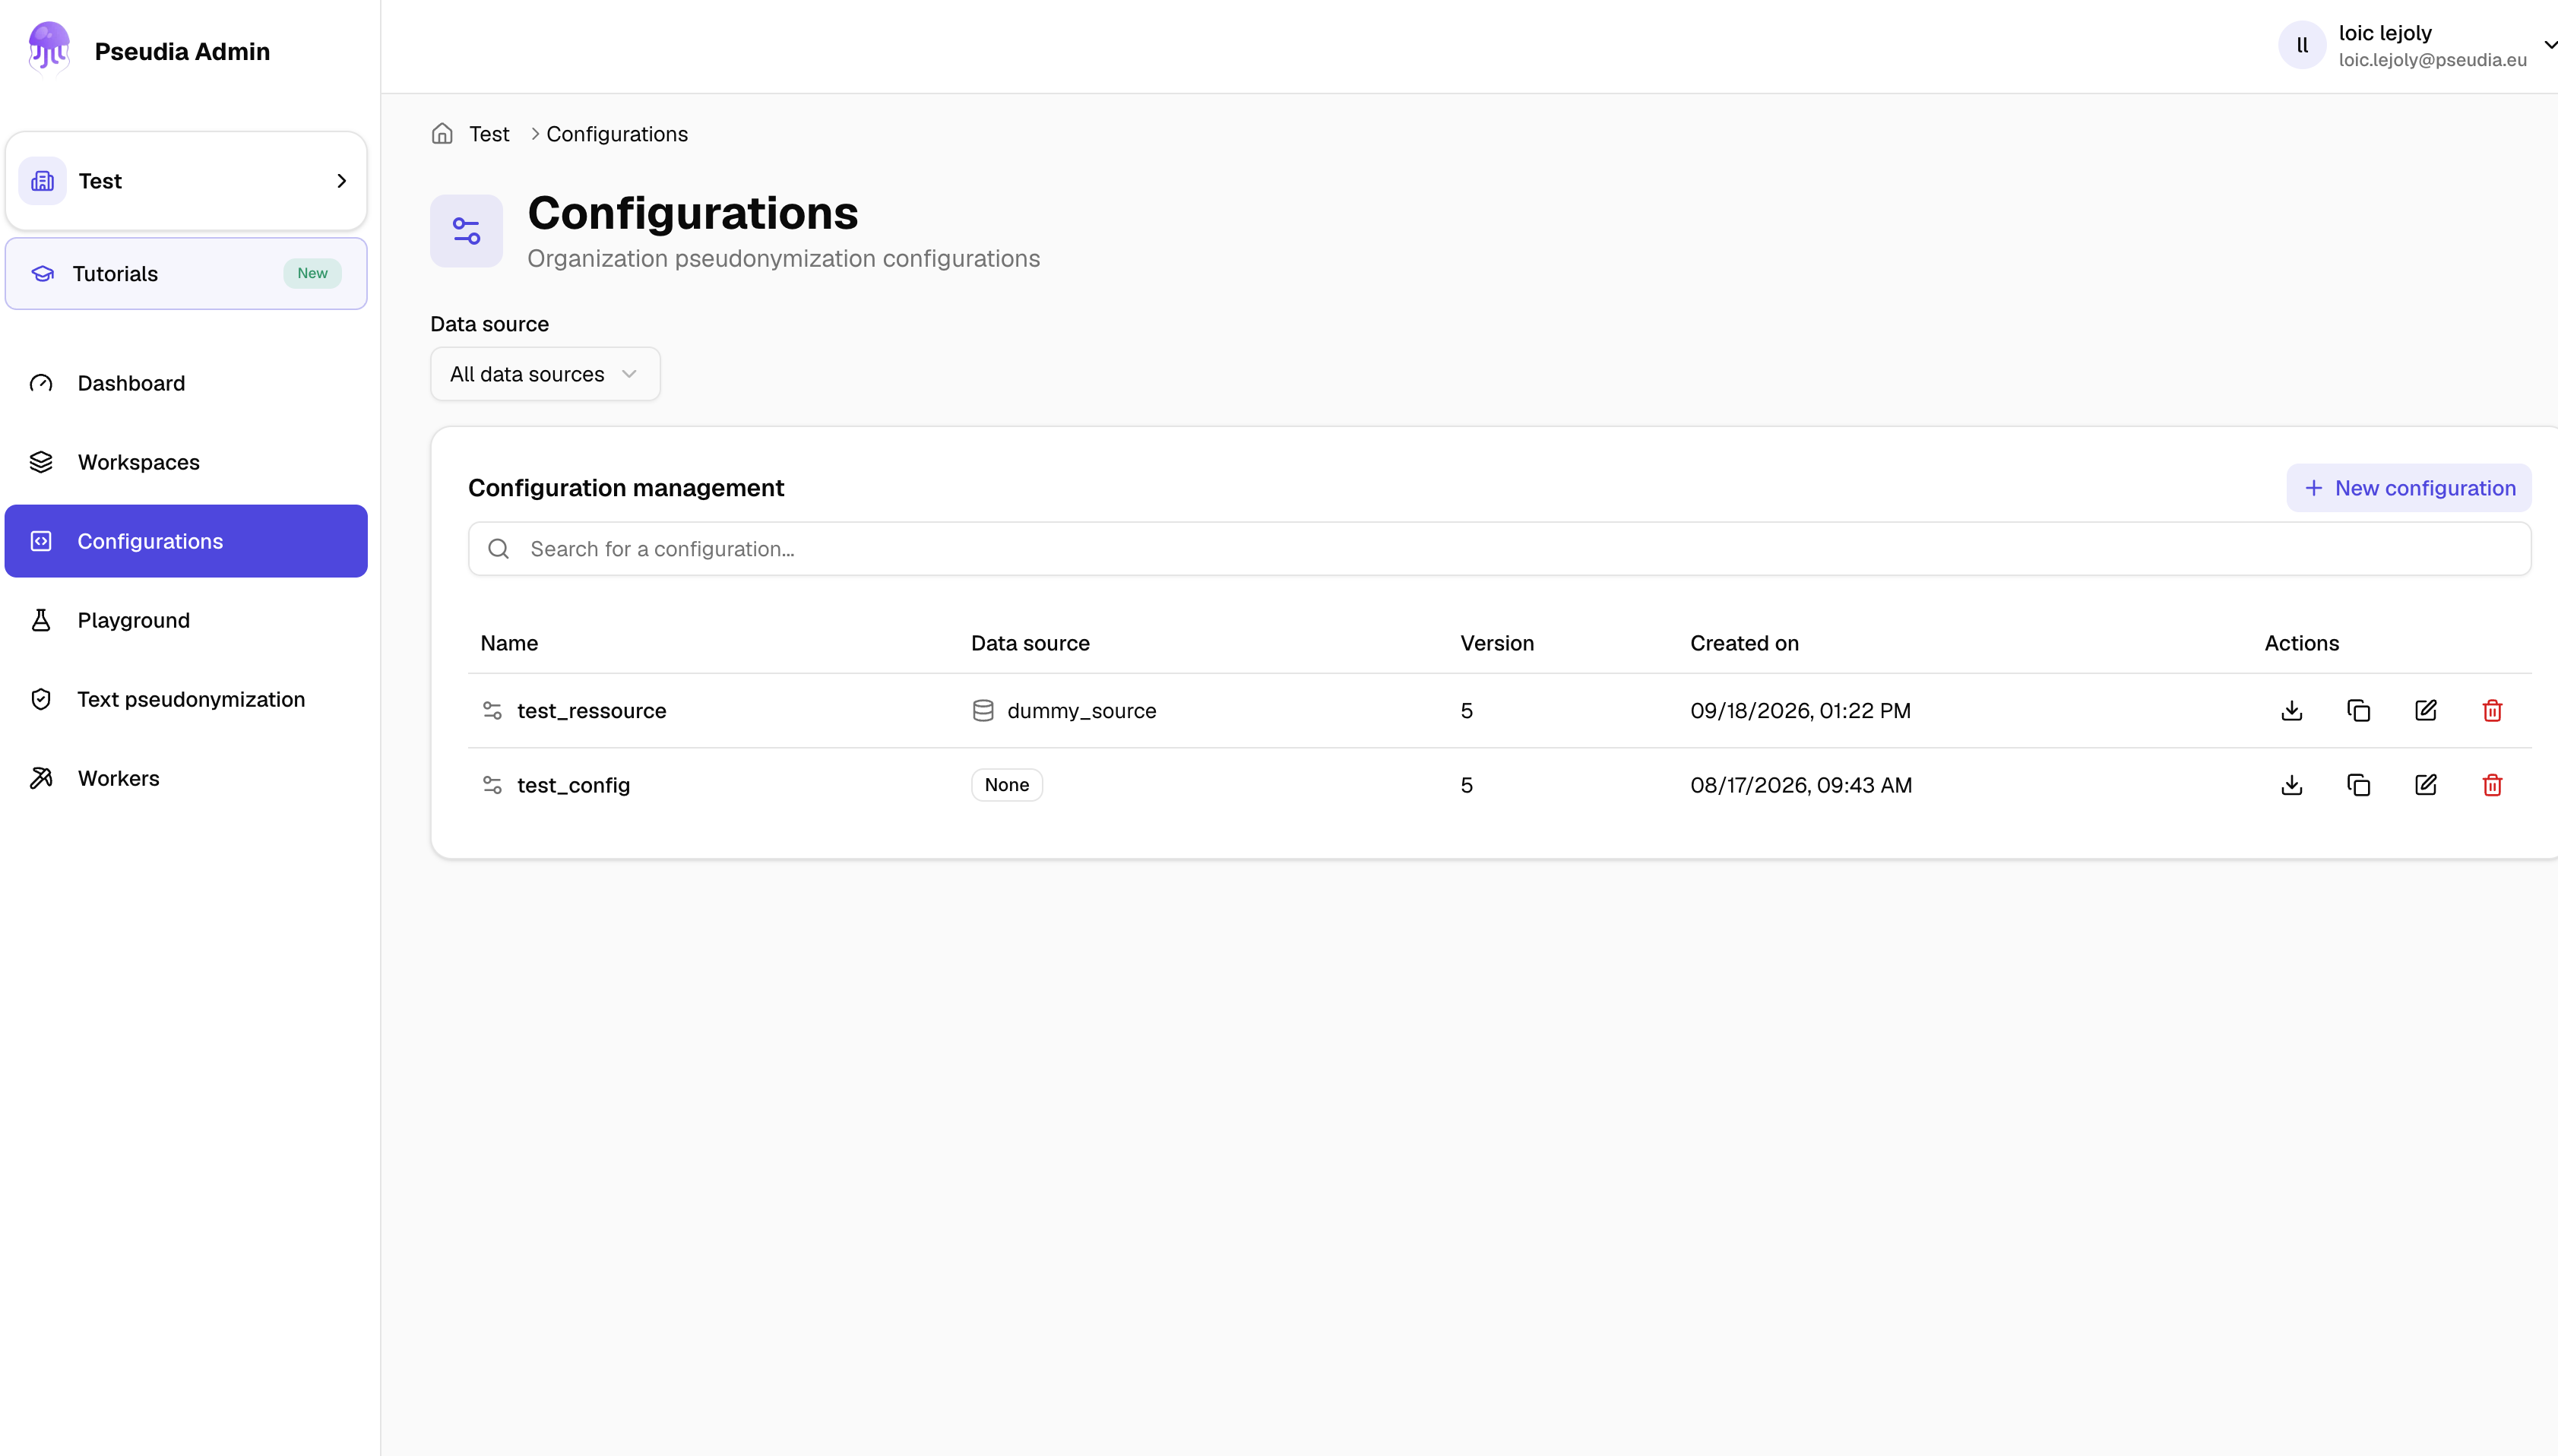
Associez une configuration à une source de données et choisissez précisément les champs à pseudonymiser, jusqu'à la colonne près.
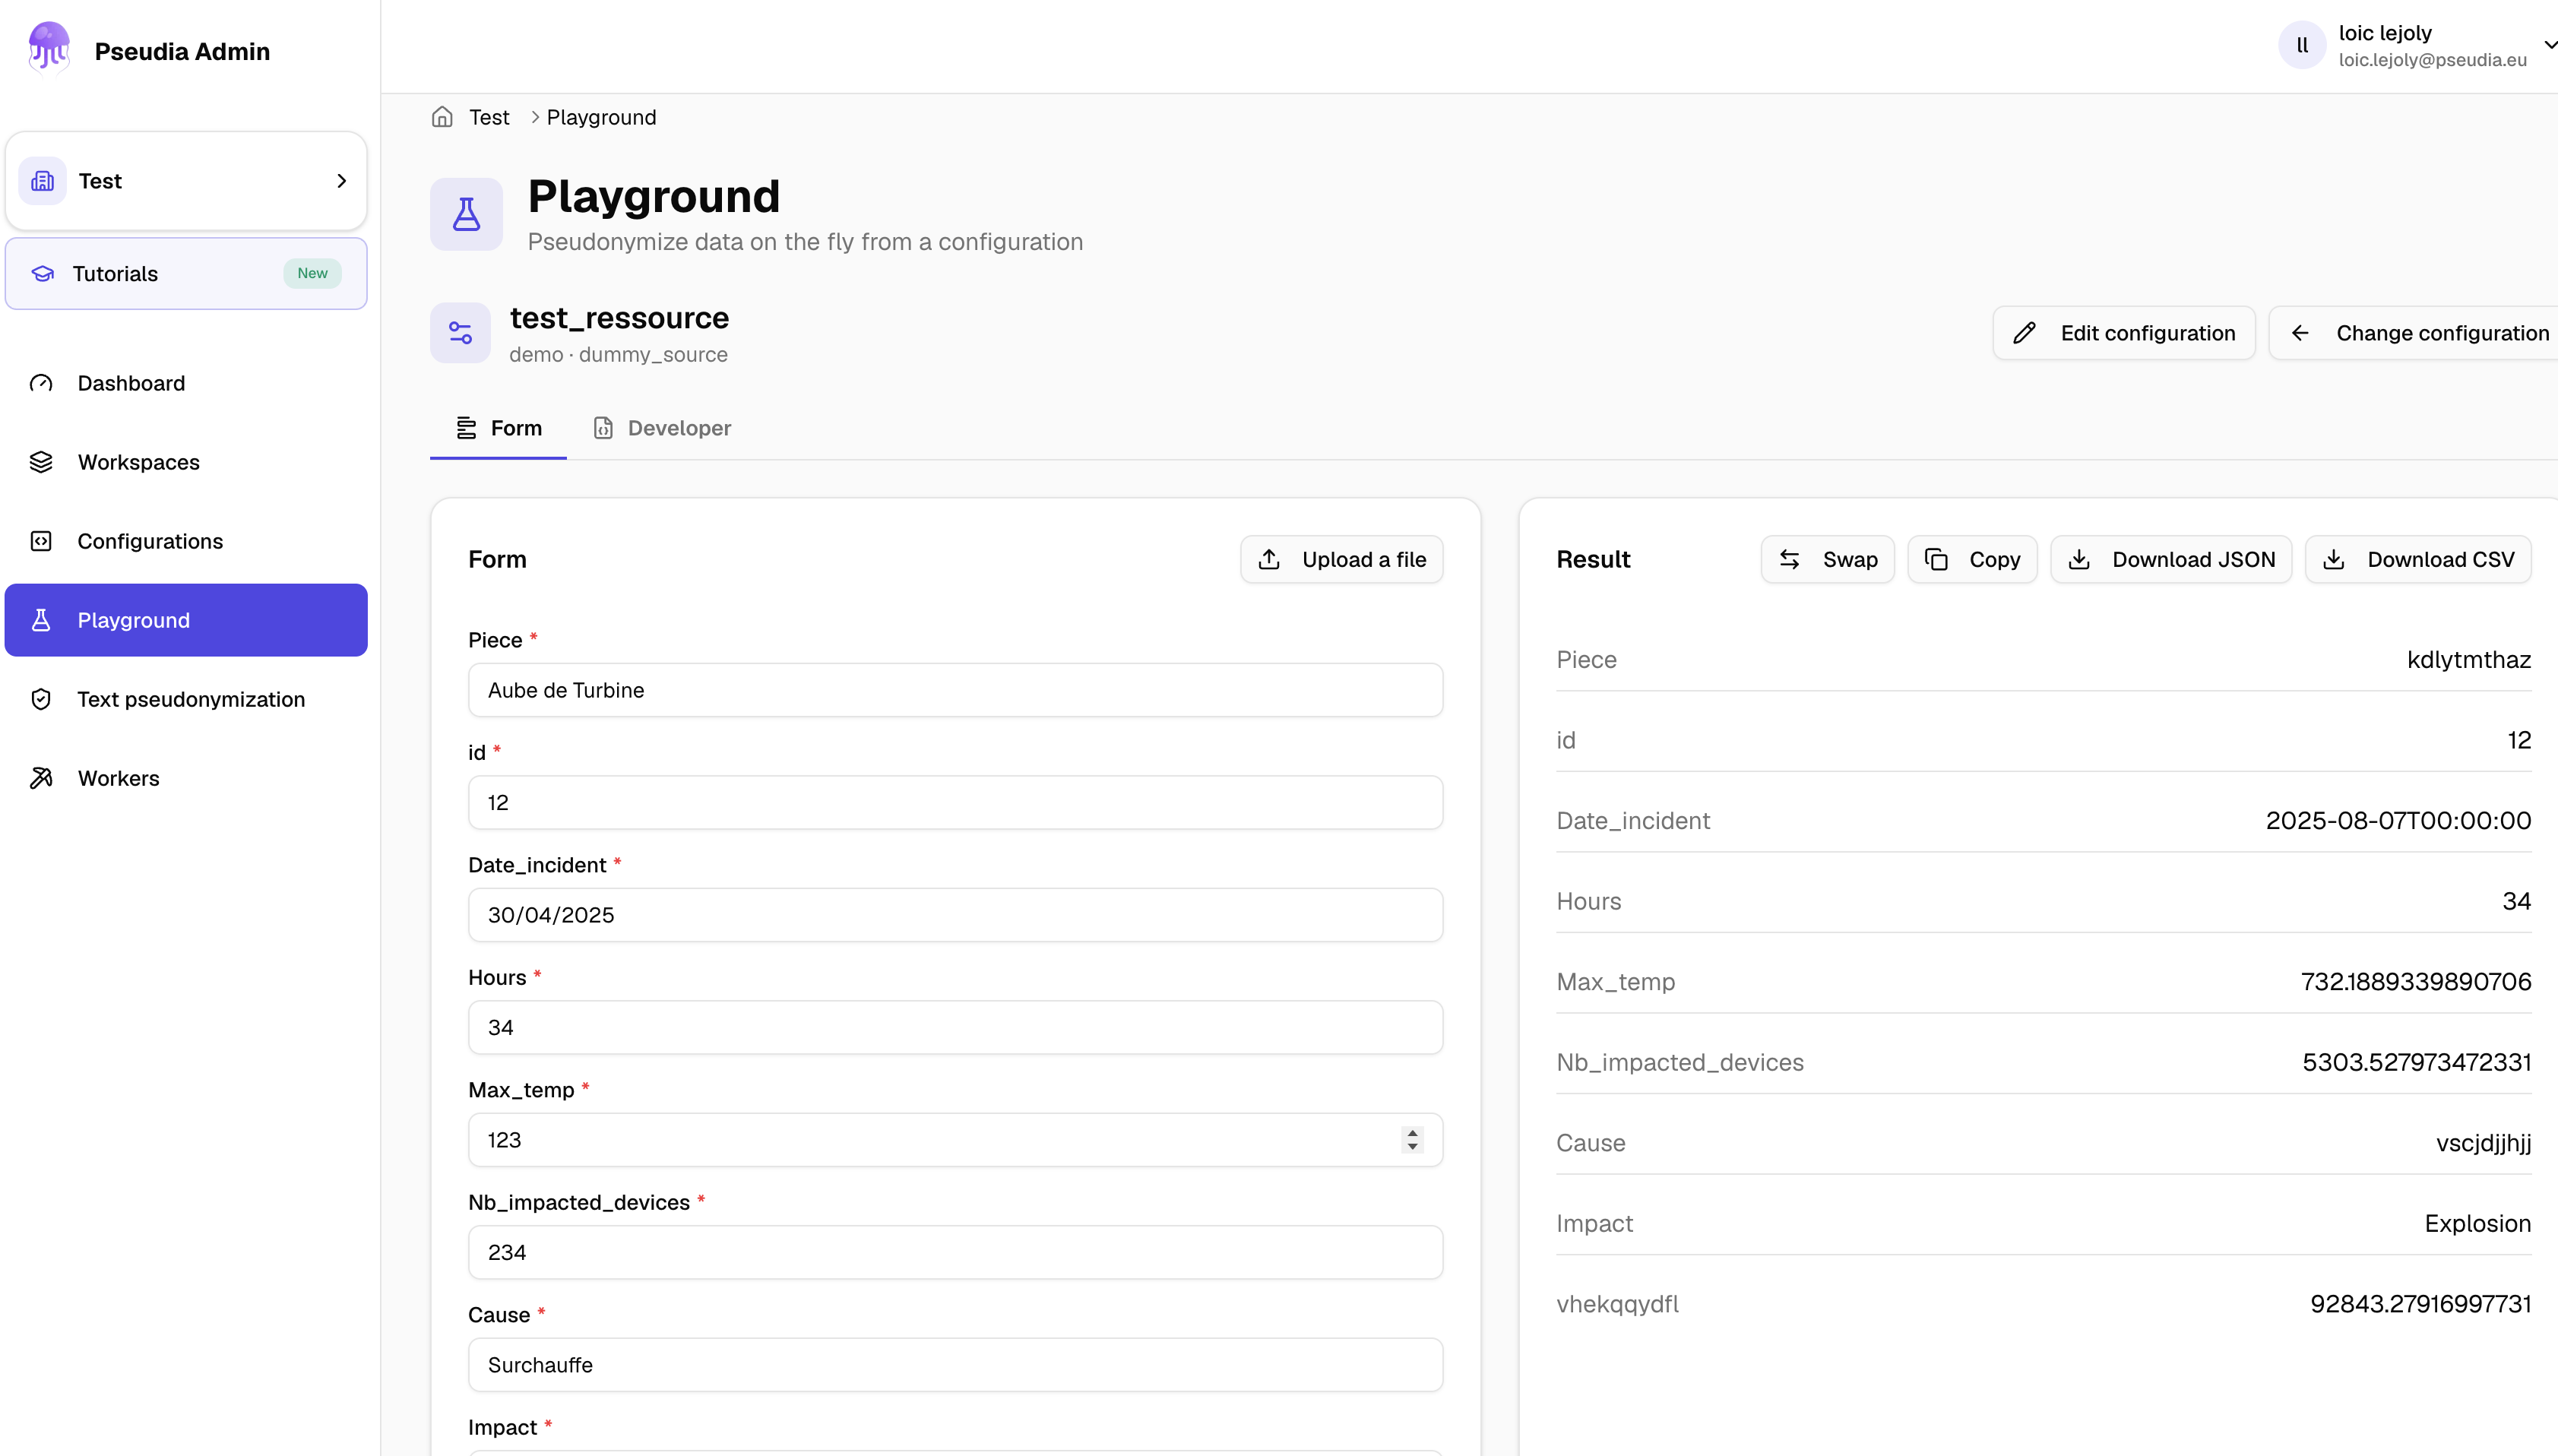
Testez une configuration sur quelques enregistrements d'exemple avant de connecter une vraie source, idéal pour une vérification rapide ou quand aucune source n'est encore définie.
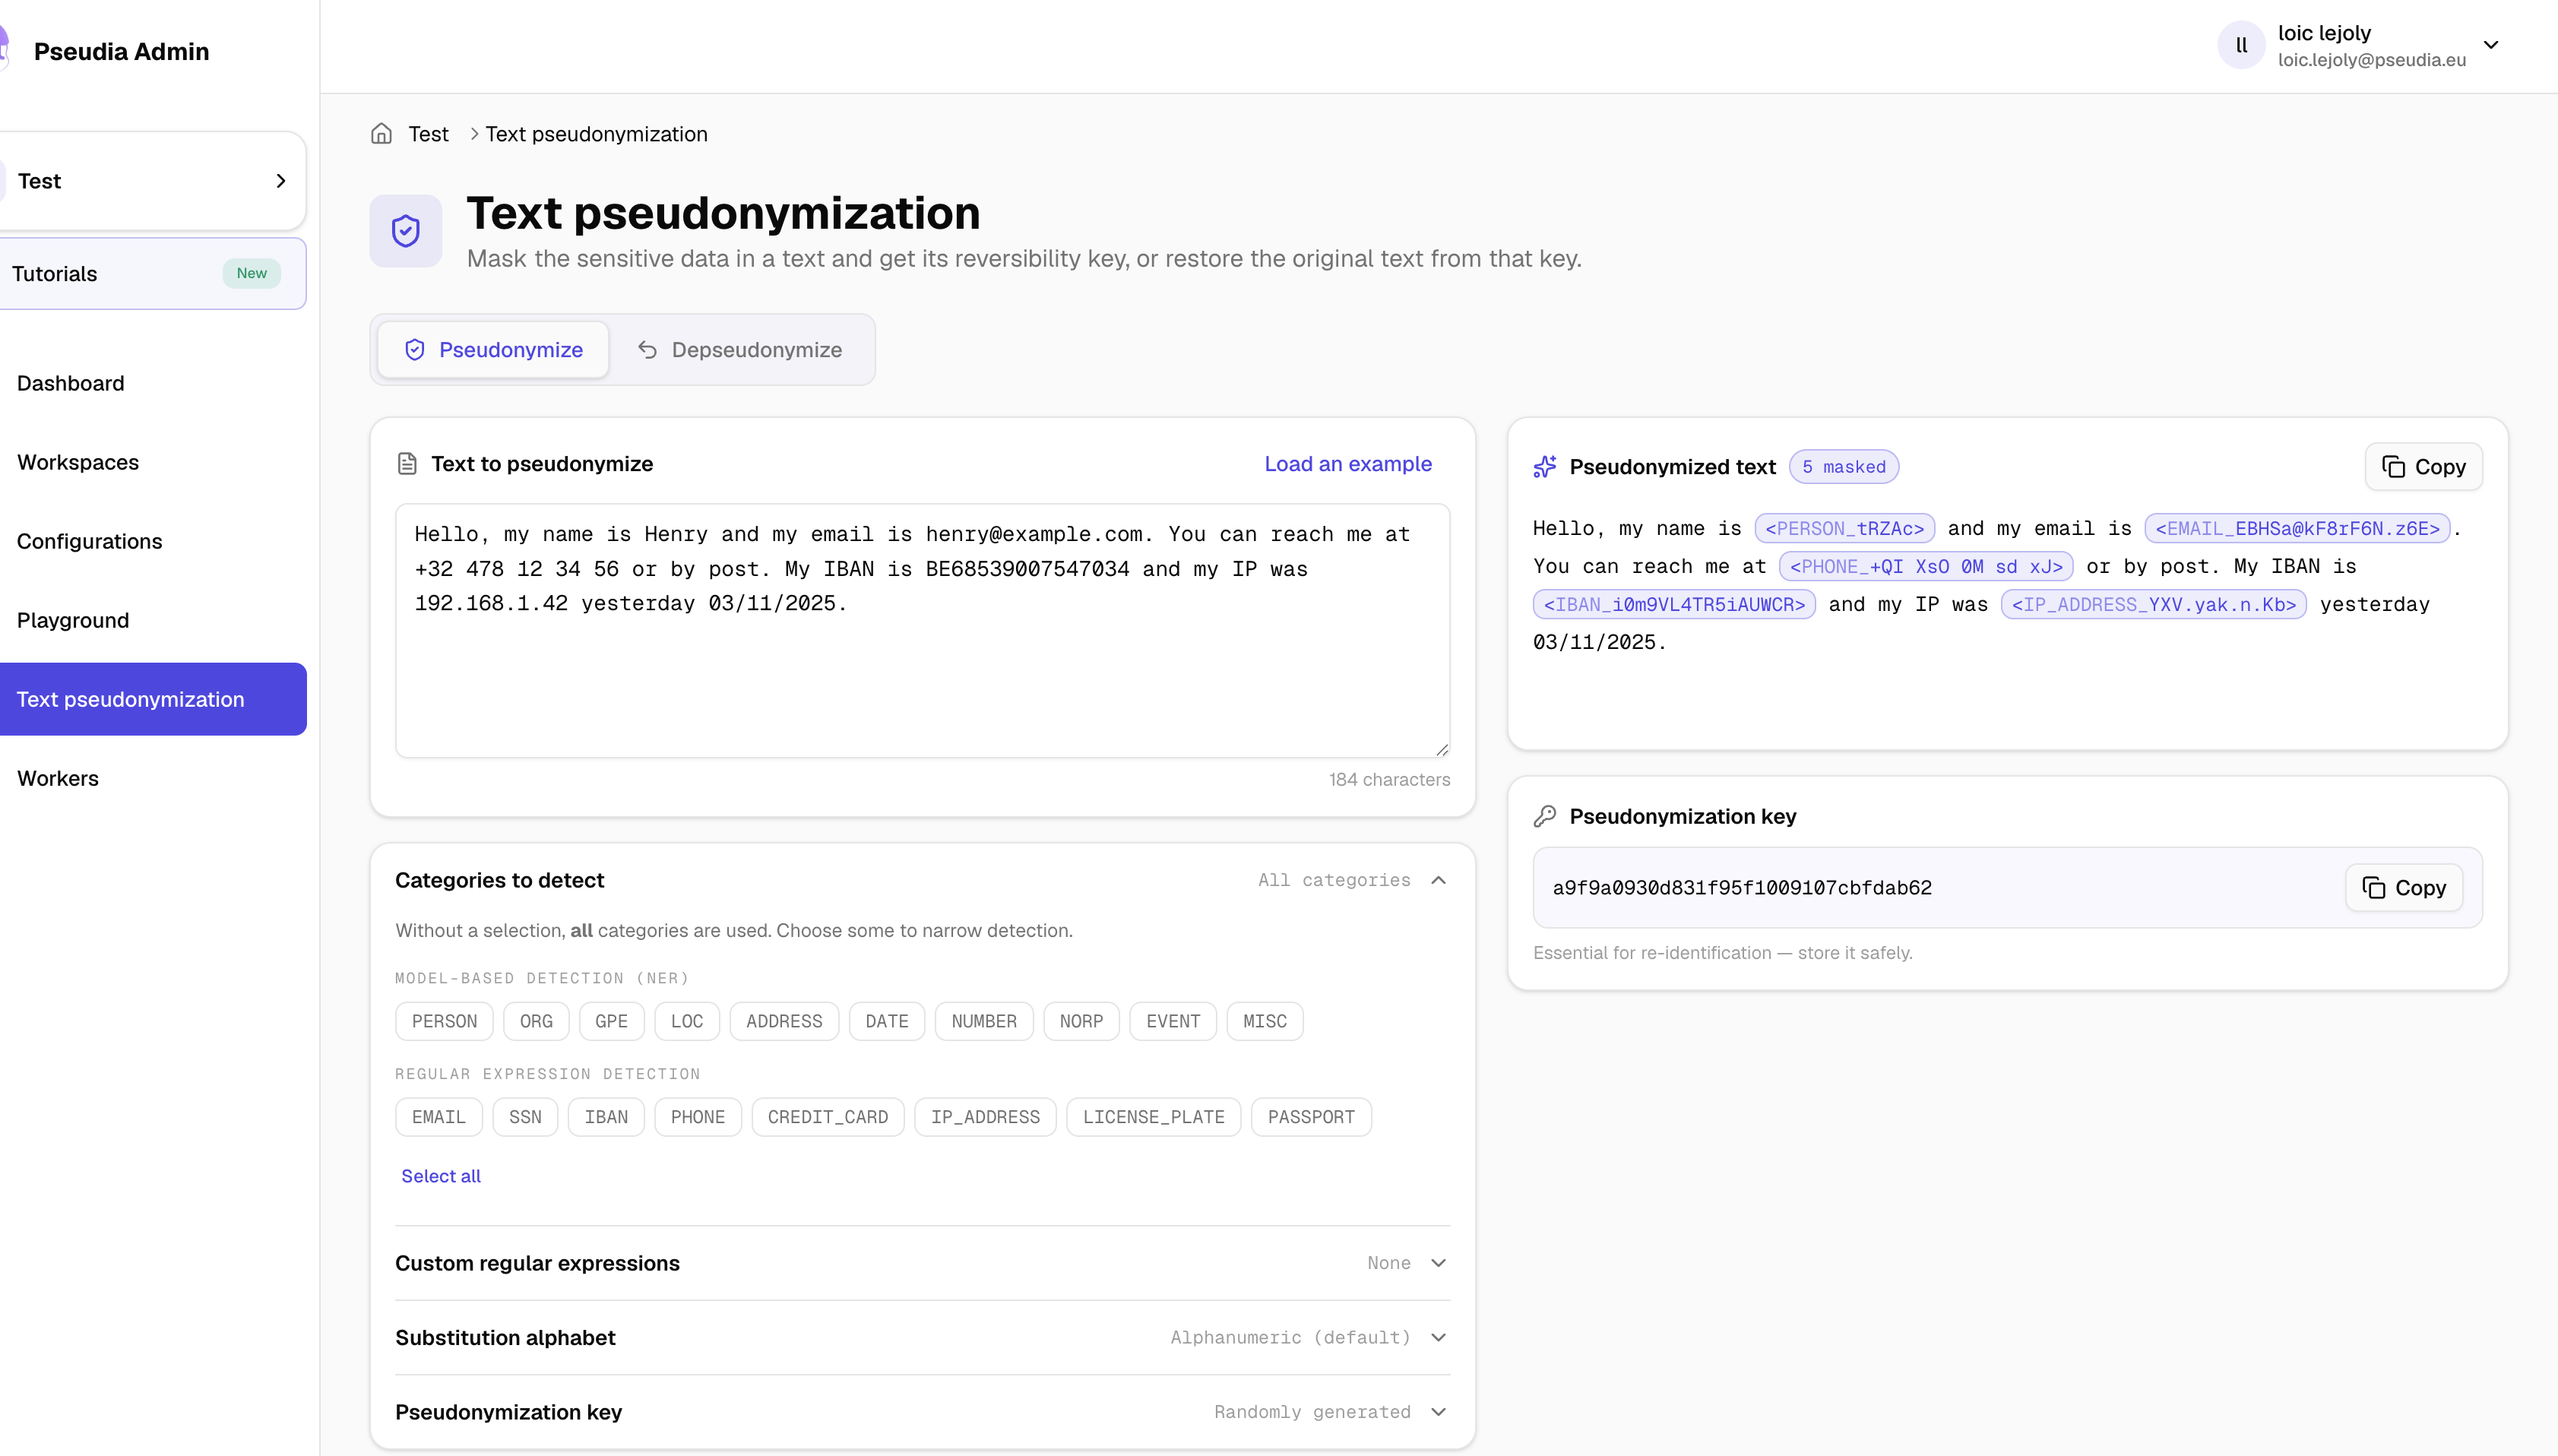
Détectez et masquez les informations sensibles directement dans du texte non structuré, comme des e-mails, notes ou tickets de support.
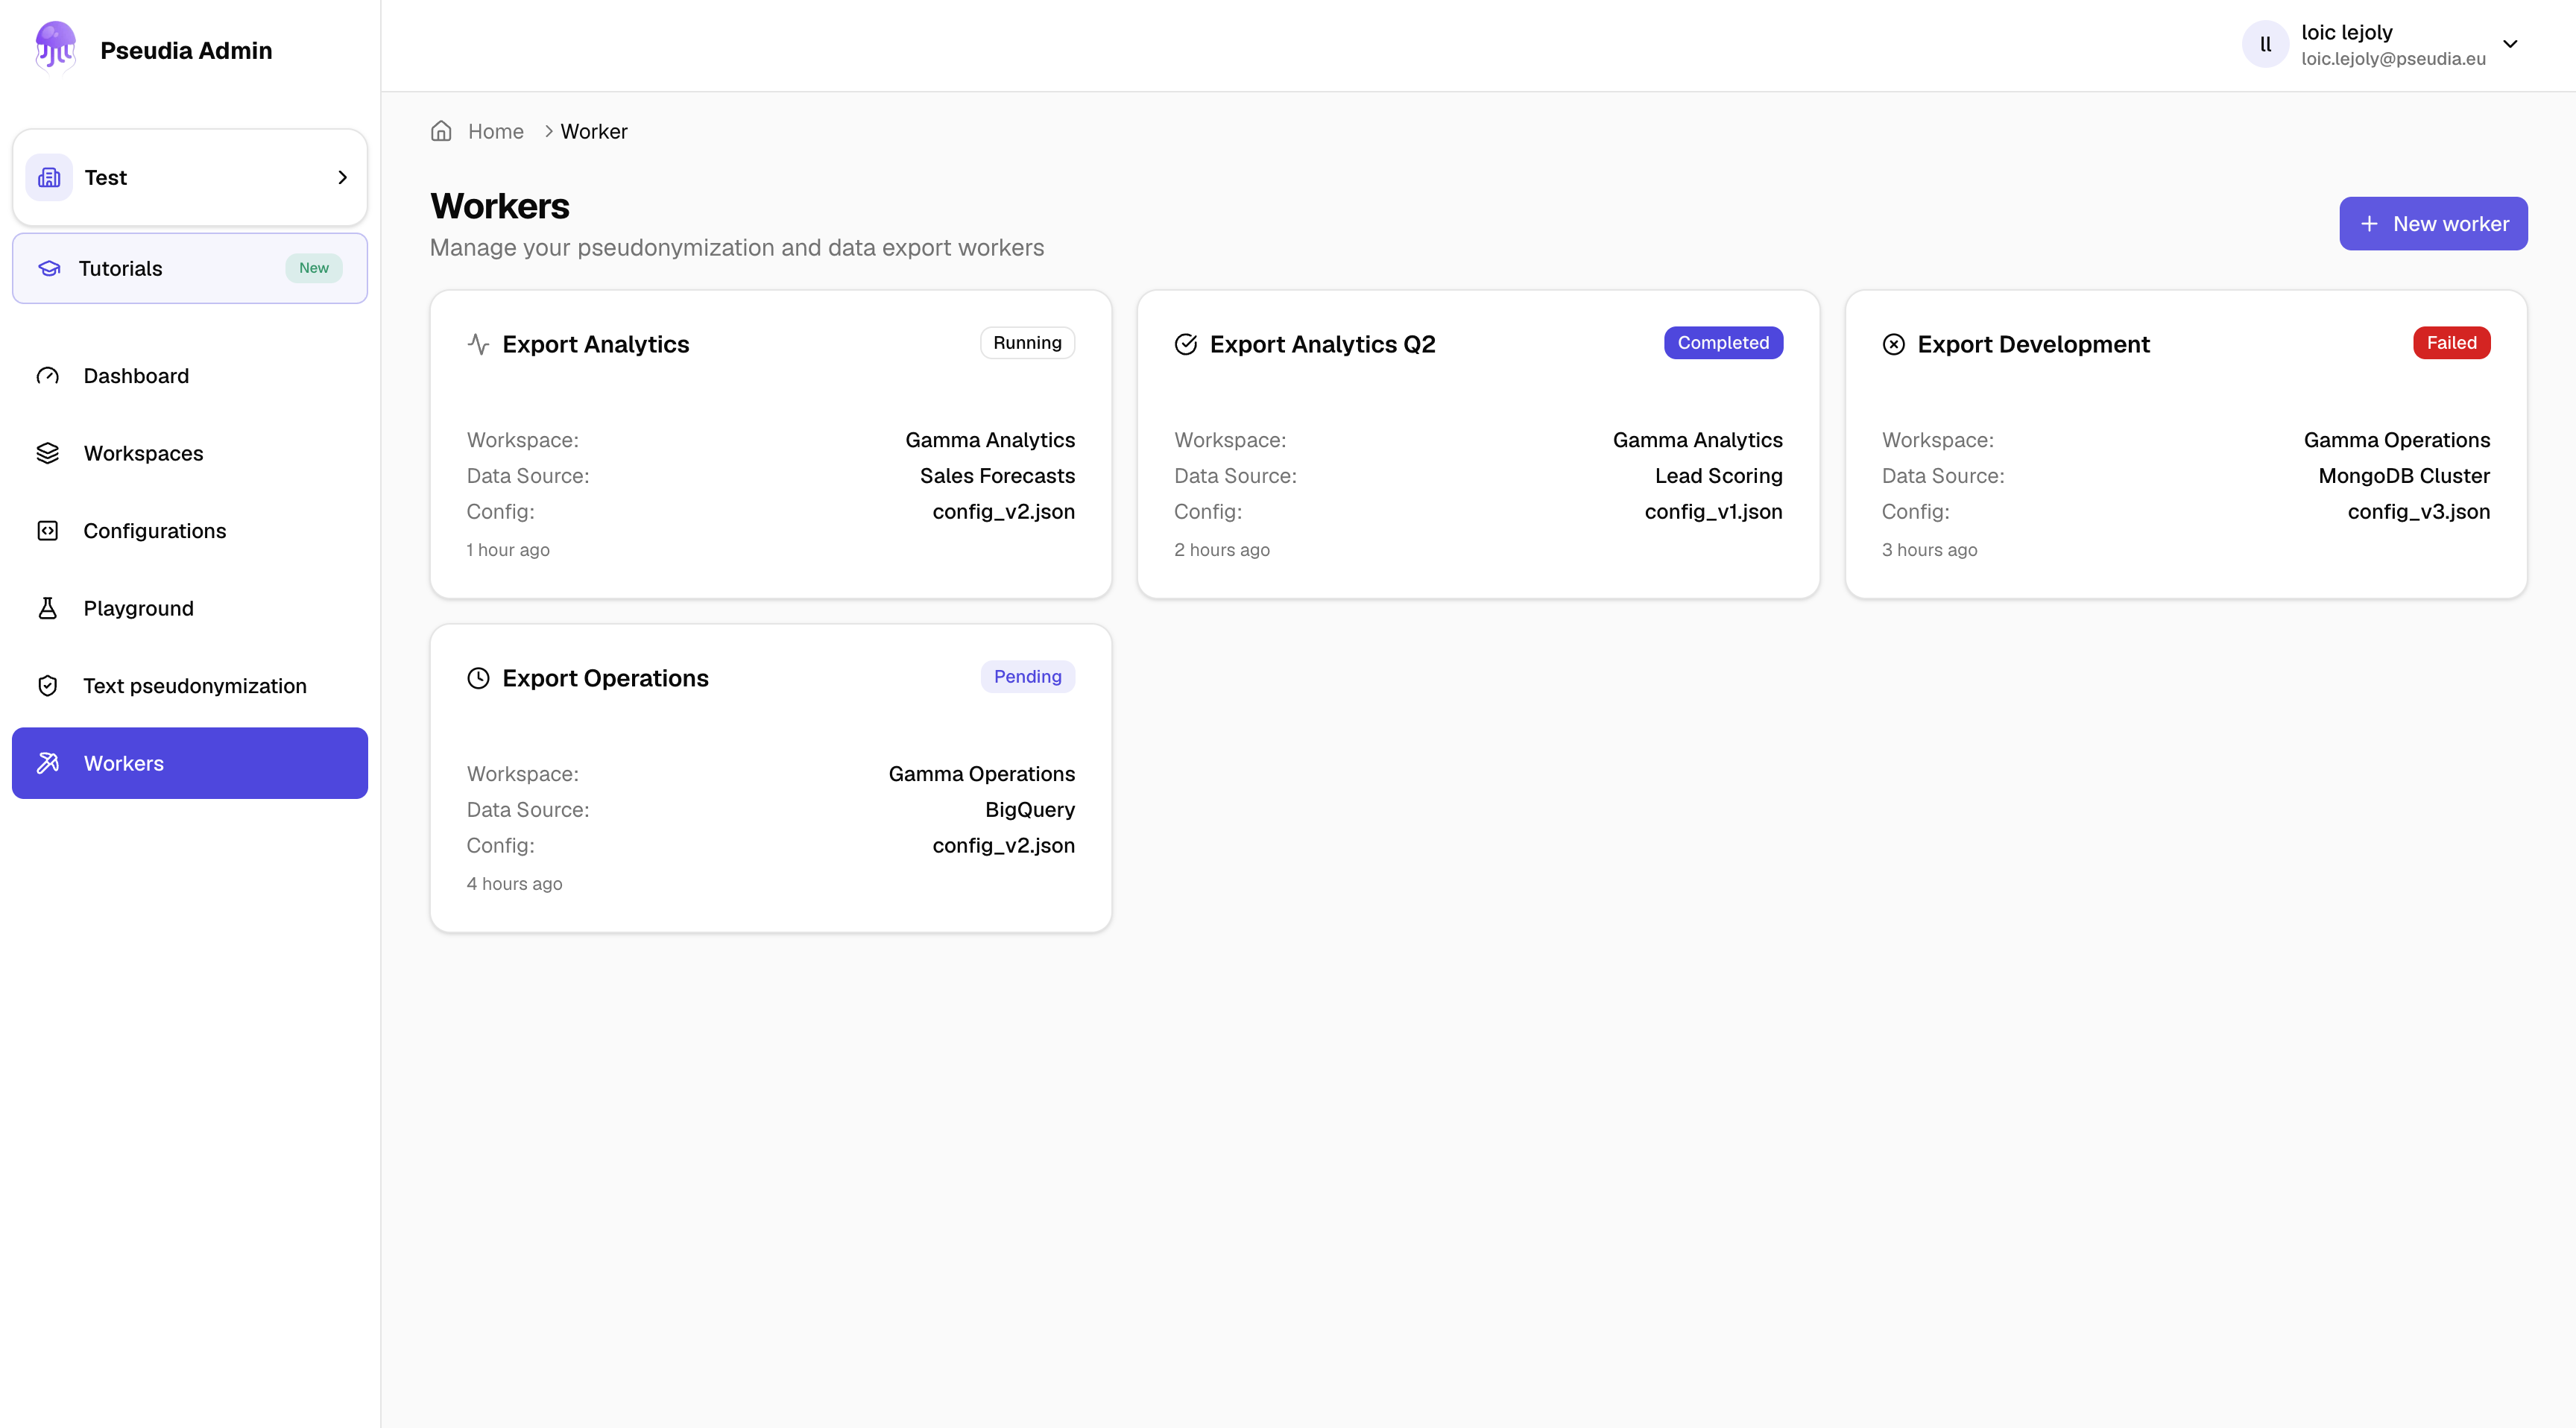
Exécutez votre configuration de pseudonymisation en traitement par lots sur une source de données complète, suivie depuis un tableau de bord unique.
Une architecture où la clé ne co-réside jamais avec les pseudonymes. Une fuite expose des pseudonymes, pas des personnes.
CISOGénérez des jeux de données réalistes à la demande : même structure, même distribution et cohérence relationnelle préservée.
InnovationPseudonymisez prompts, documents et sources RAG avant qu’ils n’atteignent un LLM externe. Vos équipes conservent leurs outils d’IA préférés.
IAConfigurez, tracez et exportez. Chaque traitement est documenté et auditable. Prouvez la conformité au lieu de simplement la déclarer.
DPOIntégrez vos propres algorithmes via l’API si nos fonctions natives ne couvrent pas vos contraintes sectorielles spécifiques.
FlexibilitéConçu et hébergé en Europe. Zéro transfert de données hors UE par défaut. Déploiement sur site (On-premises) disponible.
SouverainetéAvant de choisir, il faut savoir ce qu'on compare vraiment.
Seul le nom est supprimé. Le reste (IBAN, âge, code postal) continue de circuler librement. En recoupant quelques champs, 87 % des individus sont ré-identifiables. (MIT, Sweeney)
Mathématiquement fondée. Chaque individu devient indiscernable d’au moins k autres : la ré-identification par recoupement devient très improbable.
Un modèle génère un jeu de données fictif, statistiquement proche du réel. Aucun individu réel n'apparaît dans le résultat.
Les identifiants réels sont remplacés par des jetons cohérents ou des valeurs fictives réalistes. Marie Dupont → psd_k8x2m. Les identifiants indirects comme le code postal peuvent être rendus moins précis. Structure, distribution et relations entre tables restent intactes. Une clé séparée permet la réversibilité sur autorisation, tracée et auditée.
¹ Les données pseudonymisées restent techniquement des données personnelles tant que la clé de ré-identification existe. Le RGPD s'applique. Pseudia réduit drastiquement le risque réel d'exposition, mais ne remplace pas les obligations légales associées.
Trois étapes. Sécurisé. Souverain. Réversible.
Une checklist pratique de deux pages pour les équipes sécurité et data, bientôt disponible. Laissez votre e-mail et nous vous l'enverrons dès sa sortie.
12 vérifications concrètes à faire avant de brancher des données réelles sur vos pipelines de test, IA ou analytics, cartographie des données, choix de la technique, gestion des clés, et comment rendre votre démarche démontrable auprès d'un DPO.
20 min. Votre cas d'usage. Pas un pitch générique.